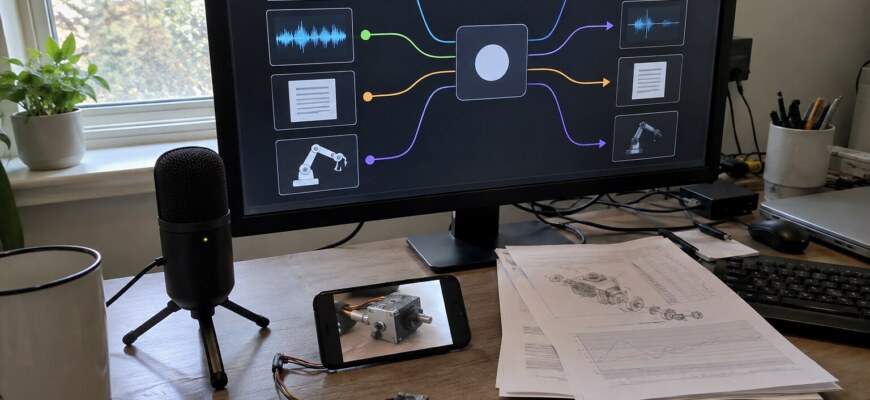
Мультимодальность расширяет возможности ИИ-агентов: система может учитывать не только текстовые команды, но и фотографии, голосовые сообщения, документы и другие данные при выборе следующего действия. Благодаря этому агенту становятся доступны задачи, в которых информации из одного текстового запроса недостаточно. Однако способность понимать изображение ещё не означает умения правильно выполнить задачу. Для этого нужны инструменты, логика управления, проверки и ограничения полномочий.
Я предлагаю разобраться в этой теме через устройство самого агента. Так будет понятнее, почему добавление камеры или распознавания речи иногда принципиально меняет рабочий процесс, а иногда только усложняет систему. Заодно посмотрим, как выбрать подходящую архитектуру и убедиться, что агент действительно решает задачу, а не создаёт убедительное описание собственных ошибок.
Мультимодальная модель и ИИ-агент: в чём разница
Мультимодальной называют модель, способную обрабатывать несколько типов информации. Например, она может получать текст и изображение, сопоставлять их содержание и формировать ответ. Некоторые системы работают также с аудио, видео и структурированными данными. Поддерживаемые форматы зависят от конкретной реализации.
ИИ-агент устроен шире. Он получает задачу, определяет необходимые действия, обращается к разрешённым инструментам, анализирует результаты и решает, что делать дальше. Модель может быть частью такого механизма, но сама по себе возможность распознать фотографию не делает её автономным агентом.
Представь три варианта. Обычный текстовый помощник читает сообщение и составляет ответ. Мультимодальная модель дополнительно рассматривает приложенный снимок. Агентная система может извлечь из снимка нужные признаки, проверить доступные записи в базе и подготовить заявку. Если разрешено, она выполнит соответствующее действие через подключённый инструмент.
Поэтому главный эффект мультимодальности я вижу в расширении доступного агенту контекста. Вместо требования предварительно переводить всё в текст можно передавать информацию в её естественном формате.
Как устроен цикл работы мультимодального агента
Рассмотрим условную ситуацию: человек фотографирует неисправное устройство и пишет, что оно перестало нормально работать. Агент должен помочь разобраться с дальнейшими действиями, но не имеет права выдавать предположение за подтверждённую неисправность.
- Получение информации. Система принимает фотографию, текстовое описание и доступные метаданные. Проверяет, поддерживаются ли форматы и достаточно ли качества изображения.
- Интерпретация. Модель выделяет видимые элементы, маркировку, сообщения на экране и возможные признаки повреждения. Текст пользователя помогает установить контекст.
- Сопоставление. Агент связывает извлечённые признаки с описанием проблемы и отмечает противоречия либо недостающие сведения.
- Планирование. Система определяет следующий допустимый шаг: запросить дополнительный снимок, уточнить симптом или обратиться к справочнику.
- Вызов инструмента. При наличии соответствующего разрешения агент выполняет поиск в базе инструкций либо создаёт черновик обращения.
- Проверка. Результат сопоставляется с исходной задачей. Если данных недостаточно, агент должен сообщить об этом, а не подменять неопределённость догадкой.
Такой цикл может повторяться несколько раз. После каждого обращения к инструменту появляется новая информация, которая влияет на план. Именно эта обратная связь отличает последовательное агентное выполнение от однократного анализа картинки.
Что меняется благодаря изображениям, аудио и документам
Изображения и скриншоты
Фотография позволяет увидеть признаки, которые человеку трудно передать словами: расположение деталей, внешний вид повреждения, обозначения на панели или состояние интерфейса. Скриншот помогает определить, какой экран открыт и какие элементы доступны.
Но фотография не раскрывает скрытые причины неисправности. По внешнему виду нельзя надёжно установить электрические параметры или состояние внутренних компонентов. Я бы использовал визуальный анализ прежде всего для уточнения проблемы и выбора следующей проверки.
Голосовые сообщения
Аудио позволяет принимать обращения без ручного ввода текста. Распознавание речи переводит сказанное в данные, пригодные для дальнейшей обработки. Если система непосредственно анализирует звук, она может учитывать дополнительные акустические признаки в пределах возможностей используемой модели.
Здесь легко потерять смысл из-за фонового шума, неправильного распознавания терминов и неоднозначных формулировок. Поэтому перед значимыми действиями полезно показывать пользователю, что именно система поняла.
Документы и структурированные данные
С документами агент работает на нескольких уровнях. Он может извлекать текст, распознавать таблицы, учитывать расположение блоков и сопоставлять поля с записями в другой системе. Это полезно, когда нужная информация представлена одновременно текстом, изображениями и таблицами.
Нужно различать настоящий текстовый PDF, скан и электронную таблицу. Для каждого формата могут потребоваться разные инструменты. Универсальное распознавание не отменяет проверки чисел, единиц измерения и связей между строками.
Где мультимодальный агент приносит практическую пользу
Чтобы не обсуждать возможности отвлечённо, я собрал несколько условных сценариев. Они показывают устройство процесса, а не результаты испытаний конкретных продуктов.
| Задача | Какие данные получает агент | Что может выполнить |
|---|---|---|
| Обращение в поддержку | Сообщение и скриншот ошибки | Определить контекст, найти инструкцию, подготовить ответ |
| Обработка документа | Скан и данные учётной системы | Извлечь поля, сопоставить записи, отметить расхождения |
| Голосовая заявка | Аудиосообщение | Распознать запрос, уточнить детали, создать черновик задачи |
| Визуальный контроль | Фотография изделия и описание требований | Выделить заметные отклонения и направить объект на проверку |
Например, в технической поддержке человек отправляет скриншот окна с ошибкой. Модель извлекает видимое сообщение, агент уточняет версию программы и ищет подходящую инструкцию. Если уверенности недостаточно, вместо автоматического изменения настроек система предлагает дополнительные проверки.
Другой пример ближе к автоматизации: голосовое обращение поступает в рабочий процесс n8n или аналогичный оркестратор. Один компонент распознаёт речь, другой извлекает параметры задачи, затем выполняется проверка обязательных полей. Создание записи возможно только после выполнения заранее установленных условий.
В визуальном контроле аналогично: анализ снимка помогает выделить подозрительные признаки, но не должен автоматически подменять измерительный контроль там, где требуются точные размеры и подтверждённые допуски.
Три способа построить мультимодального агента
Единая мультимодальная модель
В первом варианте одна модель получает несколько типов входных данных и формирует интерпретацию. Агентный контроллер управляет обращениями к инструментам и дальнейшими действиями.
Преимущество такого подхода — меньше отдельных преобразований между форматами и возможность совместно учитывать визуальный и текстовый контекст. Недостатки зависят от конкретной модели: возможны ограничения форматов, размеров входа, точности извлечения полей и доступности отдельных функций.
Специализированные компоненты с оркестрацией
Во втором варианте разные задачи выполняют отдельные компоненты. Один распознаёт речь, другой извлекает текст из документов, третий анализирует изображение. Их результаты передаются текстовому агенту или управляющему процессу.
Плюс — компоненты можно подбирать под конкретную задачу, заменять и проверять по отдельности. Минус — дополнительные этапы обработки. Если распознавание ошиблось на входе, последующие компоненты могут принять эту ошибку за достоверную информацию.
Гибридная архитектура
Третий вариант объединяет оба подхода. Мультимодальная модель анализирует общий контекст, а специализированные инструменты используются там, где требуется более строгое извлечение данных или отдельная проверка.
Например, модель помогает понять содержание документа, но суммы и идентификаторы извлекаются и сверяются специализированным обработчиком. Такое разделение особенно уместно для операций, где неверно распознанный символ способен изменить результат.
Я бы выбирал архитектуру от требований задачи, а не от количества возможностей модели. Для простой голосовой заявки иногда достаточно распознавания речи и текстового агента. Для совместного анализа сложных изображений и комментариев пользователя единая мультимодальная модель может оказаться удобнее.
Как агент связывает информацию разных форматов
Одна из сложных частей мультимодальной системы — сохранить связь между исходными данными и сделанными выводами. Представь документ с таблицей и фотографией изделия. В тексте указан один артикул, а на фотографии маркировка читается неоднозначно. Агент не должен незаметно выбрать один вариант и продолжить работу так, будто противоречия нет.
Для надёжной обработки полезно хранить исходный объект, извлечённые признаки, их происхождение и уровень неопределённости отдельно. Тогда можно установить, откуда получен конкретный параметр: из сообщения пользователя, распознавания изображения или результата запроса к базе.
Контекст задачи тоже должен быть ограничен. Если агент выполняет несколько последовательных шагов, ему требуется сохранять существенные параметры, но не переносить постороннюю информацию в следующие обращения. Особенно это касается персональных документов и данных клиентов.
Практический принцип простой: вывод должен быть связан с проверяемым входным фрагментом. Если связь установить нельзя, система должна запросить уточнение или передать задачу человеку.
Почему мультимодальность не гарантирует точности
Дополнительные каналы восприятия увеличивают объём доступной информации, но одновременно расширяют количество возможных ошибок. Я выделил бы несколько наиболее значимых ограничений.
- Ошибки распознавания. Мелкая маркировка, блики, шум и частично закрытые объекты могут привести к неверной интерпретации.
- Неоднозначность. Один и тот же визуальный признак может иметь несколько объяснений, а контекст не всегда помогает выбрать правильное.
- Потеря связей. Извлечённый текст может не соответствовать нужной строке таблицы или конкретному объекту на изображении.
- Задержки. Обработка крупных файлов и последовательный вызов компонентов увеличивают время выполнения.
- Затраты ресурсов. Передача и анализ изображений, аудио и длинных документов могут требовать больше вычислений и хранения.
- Конфиденциальность. На фотографиях, в документах и голосовых сообщениях могут присутствовать сведения, не относящиеся к задаче.
Отдельная проблема — ложная уверенность. Агент может сформулировать связное объяснение даже при недостаточных данных. Поэтому красивый ответ нельзя считать доказательством правильного восприятия или успешного выполнения операции.
Не стоит также путать качество распознавания с качеством решения. Модель может правильно прочитать надпись на экране, но выбрать неподходящий инструмент. И наоборот: корректный план бесполезен, если исходные сведения извлечены неверно.
Как ограничить действия мультимодального агента
Когда система только объясняет изображение, ошибка обычно остаётся в ответе. Если она способна отправлять сообщения, изменять записи или управлять оборудованием, последствия могут выходить за пределы переписки.
Поэтому права доступа лучше определять отдельно от возможностей модели. Агенту не требуется разрешение на изменение всей базы только потому, что он умеет распознавать документы.
- Предоставь минимальный набор инструментов, необходимый для конкретной задачи.
- Раздели операции чтения, подготовки черновиков и изменения данных.
- Перед значимым действием проверяй обязательные параметры независимо от текстового вывода модели.
- Для необратимых или потенциально опасных операций требуй явного подтверждения уполномоченного человека.
- Сохраняй журнал запросов к инструментам, решений и результатов с учётом правил хранения данных.
- Предусмотри безопасную остановку и обработку ошибок внешних систем.
Есть ещё один нюанс: содержимое фотографии, документа или распознанного сообщения следует считать входными данными, а не управляющими инструкциями. Если внутри документа написано требование отправить информацию куда-то ещё, агент не должен выполнять его без независимой авторизации. Это относится и к тексту, который попал в систему через распознавание изображения.
Как проверить, что мультимодальный агент работает правильно
Проверять такого агента одним вопросом и удачным ответом недостаточно. Нужен набор типичных задач с заранее определённым ожидаемым поведением. Желательно включить не только понятные примеры, но и неоднозначные изображения, неполные документы, шумные записи и противоречивые данные.
| Критерий | Что проверять |
|---|---|
| Интерпретация | Правильно ли извлечены признаки из каждого формата |
| Согласованность | Верно ли связаны текст, изображение и данные инструментов |
| Завершение задачи | Получен ли ожидаемый проверяемый результат |
| Ошибочные действия | Возникали ли неверные или неразрешённые операции |
| Задержка | Сколько времени занимает полный рабочий процесс |
| Ресурсы | Каковы затраты на обработку и хранение данных |
Я бы проверял каждый слой по отдельности. Сначала — распознавание исходных данных. Затем — правильность решения о следующем шаге. После этого — вызовы инструментов и соответствие конечного состояния ожидаемому.
Особенно полезны отрицательные сценарии: размытая фотография, неподходящий документ, отсутствие доступа к сервису. Хороший результат в таких случаях может состоять в корректном отказе от действия и запросе уточнений.
Если после внедрения новой модальности выросло число успешных задач, важно убедиться, что одновременно не увеличилось количество опасных или ошибочных операций. Оценивать нужно весь цикл, а не только способность модели описать входной файл.
Когда мультимодальность действительно нужна
Перед проектированием я предлагаю пройти короткую последовательность вопросов. Она помогает не усложнять агентную систему без необходимости.
- Какие данные реально поступают? Если задачи полностью описываются текстом и структурированными полями, дополнительные модальности могут быть избыточными.
- Требуется ли понимать взаимосвязи? Если изображение нужно лишь для извлечения текста, специализированного распознавания иногда достаточно. Если требуется сопоставлять расположение объектов с инструкциями, мультимодальная модель может быть полезнее.
- Какие действия разрешены? Определи, должен агент консультировать, формировать черновики или изменять внешние системы.
- Какова цена ошибки? Чем серьёзнее последствия неверной интерпретации, тем важнее независимая проверка.
- Можно ли оценить результат? Нужны понятные критерии правильности и тестовые задания.
- Оправданы ли ресурсы? Сравни полноценную мультимодальную обработку с более простой последовательностью специализированных компонентов.
Для первого рабочего варианта разумно ограничить систему одной задачей и небольшим набором разрешённых инструментов. Затем проверить её на разнообразных входных данных, разобрать ошибки и только после этого расширять полномочия или количество поддерживаемых форматов.
Итог: что меняется в развитии агентов
Мультимодальность позволяет агенту работать с информацией, которая раньше требовала отдельного описания человеком. Он может учитывать внешний вид устройства, содержание документа, голосовое обращение и результаты программных инструментов в одном процессе.
На практике это меняет получение контекста, планирование, состав доступных задач и требования к контролю. При этом автономность зависит не от количества поддерживаемых форматов, а от архитектуры, разрешённых действий и качества обратной связи.
Мой основной вывод: начинай не с поиска самой универсальной модели, а с конкретного рабочего сценария. Определи, какие данные необходимы для решения, где возможна ошибка восприятия и каким способом будет подтверждён результат. Тогда мультимодальность станет обоснованной частью автоматизации, а не дополнительным источником сложности.